今週の参加記は山田 のABC471 です!
ABC471
連続21回目の rated-ABC です。
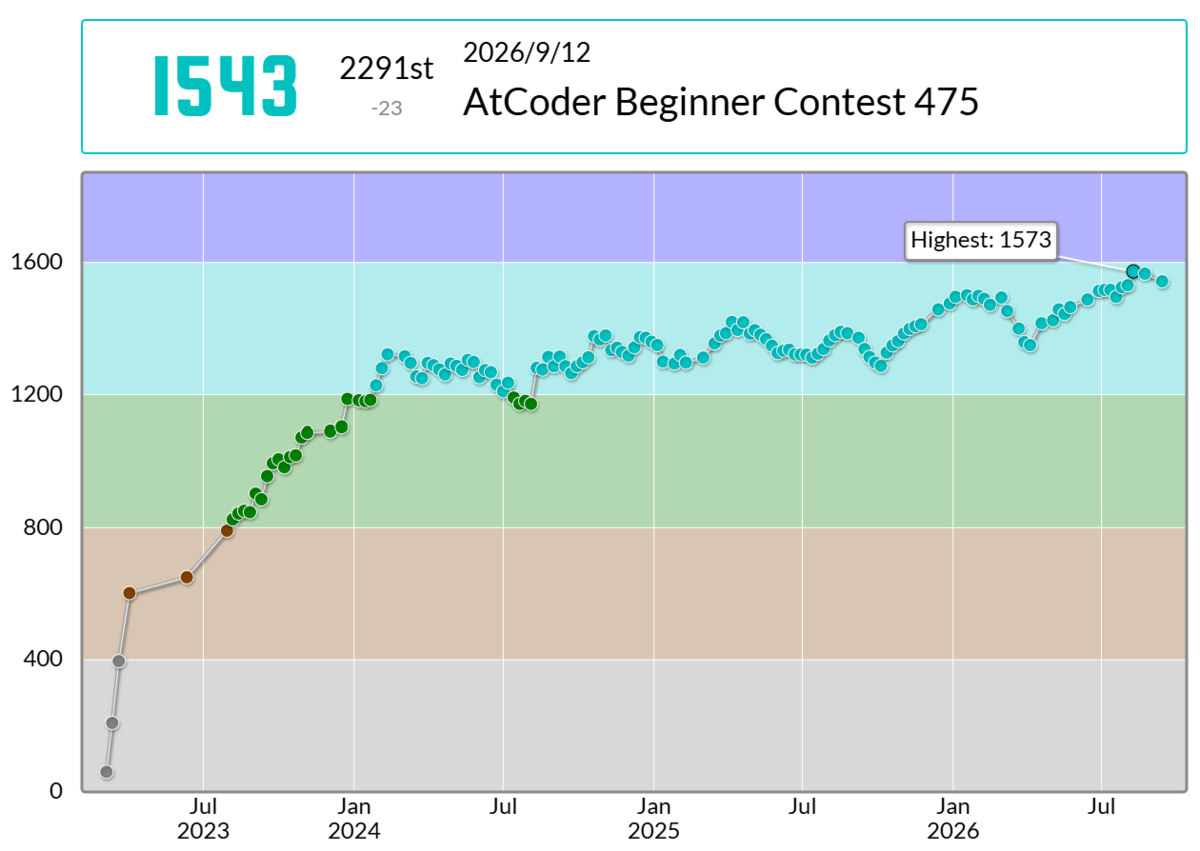
先週は1日だけ黄色 状態に戻れたものの、翌日の ARC226 で即剥奪されました。
コンテスト前の山田のレートは 1994 でした。復帰に必要なパフォーマンスは 2050 で、コンテスト中普通にしていればそのまま復帰できると思います。
ここ数ヶ月は配点が信用ならない傾向にありますが一応確認しておくと 100-200-300-400-450-550-600 。E 問題までは普通 or 簡単めの配点で F 問題が難しいっぽいです。ですが最近特に E までに落とし穴がありまくるので、ここをいかに躓かずに駆け抜けられるかでも差がつきそうです。また G 問題を通せる可能性も低くなく、F 飛ばし 6 完で一気に上位に浮上なんてルートもありえます。
A問題
問題文: A - Nice or Nein
Difficulty: 19
KCPCメンバーのAC率: 10/10
条件を a == 9 || b == 9 と誤読して若干ロスしました。
1:42 AC 。
B問題
問題文: B - Survey Tabulation
Difficulty: 48
KCPCメンバー(rated参加) のAC率: 10/10
区別しない文字列を文字列として同じにしたいです。小文字か大文字に揃えれば正規化 できます。
黒魔術を使います。
ASCII における英大文字/小文字は二進数表記 'A' が 1000001 と対応するのに対し、'a' は 1100001 です。
よって char c の英大文字/小文字の切り替えは c ^= 32 とすればよい、というテクがあります。大文字に揃える場合は c &= ~32 、小文字に揃える場合は c |= 32 です。
しかし何を思ったのか山田は c &= 32 と書いてしまいました。これでは
3:02 WA 。
びっくりしました。この時は本当に何が間違っているか分からなかったので、if ('a' <= c && c <= 'z') c += 'A' - 'a'; と普通のやり方に書き換えました。
4:33 AC 。
この崖の予感がする回でペナルティはまずいです。
C問題
問題文: C - Cookies and Greedy Takahashi
Difficulty: 301
KCPCメンバー(rated参加) のAC率: 10/10
列上で「最も近くにある有効なもの」を取ってくるタイプの問題は std::set 想定がちです。
しかし山田はこういう問題はセグ木上の二分探索 で片付けています。境界の調整が難しいのでアンチの多い典型だと思いますが、慣れれば楽でかつ応用性が高いと思います。
開始地点である座標 座標圧縮 しておき、現時点での各地点のクッキーのあるなしを
二分探索は ACL と同じ設計なら、cur を現在の座標(座圧後)とすると、
int L = seg.min_left (cur, [](int mx) { return mx <= 0 ; }) - 1 ;
int R = seg.max_right (cur, [](int mx) { return mx <= 0 ; });
これで右・左のクッキーの座標(座圧後)が取得できます。
実装完了して何故かサンプルが合わない と思っていたら、何故か座圧に座標
13:37 AC 。 今日はもうダメですか。
D問題
問題文: D - Chargers
Difficulty: 570
KCPCメンバー(rated参加) のAC率: 10/10
状況が複雑な上、競プロにおいて慣れない用語がいっぱい出てきて、把握に時間がかかりました。
バッテリーの最大容量は
この書き方で大量のバッテリーを扱う問題なのはすごいと思います。
問題を競プロ的な捉え方にすると、整数(残量を表している)の多重集合に対して追加・最大値取得・最大値削除・全体加算(ただし を行う問題です。全体加算がなければ優先度付きキュー 以外の何物でもないです。
全体加算をキュー内の値に一個一個直接やるのは無駄です。「これまでの加算の合計 」と「加算される前の値 」を別々に持っておくパターンです。今回は時刻
言い換えると「(最大容量無限と仮定した場合の)現在の残量
17:44 AC 。
E問題
問題文: E - Sum of Square of Sum
Difficulty: 990
KCPCメンバー(rated参加) のAC率: 7/10
総和の 2 乗って書いてあるのでとりあえず展開 した光景を考えます。大量の各項の寄与 を求めたいです。
よって
23:50 AC 。 今日の癒し枠でした。
────────
ここで初めて順位表を確認しました。
現時点でのパフォーマンスは 2122 程度でした。悪くはないものの、B 問題のペナルティと後ろの問題を通した人で抜かされていき、青 perf まで落ちるかもしれないです。
そして F 問題の現時点の AC 人数は 10 人 、G 問題は 0 人 でした。まだ序盤なので最終的にどういう難易度になるのかよくわかりません。ただ今日は F 問題と心中 することにするのが良さそうです。
前の山田担当回 で話したように、最近頻出の難しめの F 問題を山田は落としまくっており、嫌な予感がします。
F問題
問題文: F - Concat (maximize)
Difficulty: 1895
KCPCメンバー(rated参加) のAC率: 2/10
開始 24 分で F 問題と対峙。時間はたっぷりあります。
こういう辞書順が絡む問題は嘘解法祭りになりやすいですが、丁寧に合法な考察を繰り返せば確実に通せると思います。頑張ります。
「全て選んで辞書順最小化(最大化)」の場合は有名問題です。ソート①
drken1215.hatenablog.com
全部あらかじめソート① しておけば、使う文字列集合を決めれば最適な順番はその添字順になる ということになります(同じ長さの文字列同士なら辞書順比較がそのまま大小関係になっています)。この時点で LCP Array などを使ってえげつない複雑さに脳味噌を破壊しながら文字列の比較をする系なんじゃないかと身構えました。(が、実際は LCPA を使うことはありませんでした)
というわけでどんな文字列集合が最適解の候補になるか考えます。まず答えの桁数 を知りたくなります。最大桁数を達成していない解はまず最適解の候補としてありえません(ABC443F をどうしても自力 AC できなかった悔しさを覚えていたのですぐ桁数に着目できました)。leading zero がない場合は簡単で、長さ上位 の文字列を取ってくれば最大桁数になります。
leading zero について考えると頭を壊しかけたので、一旦 1 から 9 までしか入力に含まれない場合を考えてみました。
同じ長さのもの同士 でどういう優先順位で採用すればいいか考えるのが課題です。辞書降順 で良い気がしました。長さが違うもの同士を適当に扱うと崩壊するのであって、同じ長さならシンプルなやり方でいい思いました。
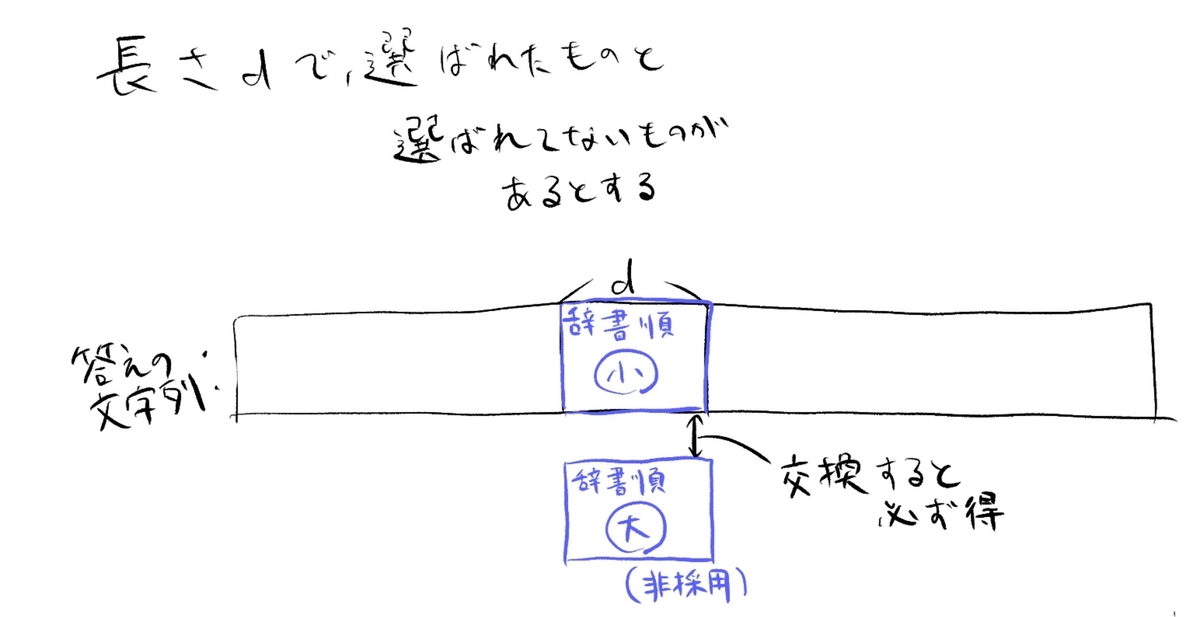
「◯◯の形をしている最適解が必ず存在する」を証明する際は、「◯◯の形でない最適解」が存在すると仮定し、そこから解を悪化させずに「〇〇の形」に修正していける という背理法チックなやり方になりがちです。今回は(長さ降順、辞書降順)の順に採用していくことの最適性を証明したいです。長さ降順で採用していいのは確かなので、「(長さ降順、非 辞書降順)で取ってきた最適解から、(長さ降順、辞書降順)への最適解に修正可能 」を証明します。これは「修正しなければならない区間」の辞書順だけを、他の区間に一切触れることなく増やすことが必ずできます。証明できてると思います。
以降(長さ降順、辞書降順)によるソートをソート②
このように leading zero 非考慮の場合は思いの外すんなり解けました。なのでこの問題の AC 人数を減らしている主要因は leading zero の扱い だろうと思いました。
選んだ二個目以降の文字列に関しては今までの考察がそのまま適用できそうです。leading zero が二個目以降まで伸びている場合は全部ゼロ の場合のみです。よって一個目を決め打ち全探索 し、残りが自動的に決まるのでそれを比較、というやり方で一旦正当な多項式解法が得られると思いました。
難しいのは比較パートを準線形に落とすところですが……。まあ先述の通り LCPA ゴリ押しでいけると思います。
残り 53 分 ぐらいで実装開始。余裕があるように見えますが、比較の詳細詰めで沼ると思うので集中していきたいです。またこの問題の現時点での Difficulty 予想が青 黄 境界ぐらいとなっており、あんまり遅いと黄色に戻れないかもしれません。
まずソート② の上位 ソート① して連結させたものを作りました。以降これを文字列 「(決め打った一個目の文字列)+( が最適解の候補です。
いよいよ今の解法の最難所、「値の比較 」を LCP Array を駆使して実装するぞ、と覚悟を決めました。しかし比較の光景を具体的に想像してみると、決め打つべき候補はそんなに多くないのでは?
具体的には、長さが同じものの中では辞書順最大 のものしか決め打つ候補にならないのではないかと思いました。
長さが同じ 二つの文字列
よって LCPA は要らないです。危うく沼解法に走るところでした。
公式解説 ではここから更に候補を 2 個に絞っていました。言われてみれば当たり前ですが、考察が積み上がっていくにつれて状況を脳内でうまく回せなくなっていました。
66:24 WA 。 うわ。
速攻で順列全探索の愚直解を書き、ランダムテストを回しました。
↓参考
info.atcoder.jp
すぐに実装ミスが二つ見つかりました。大雑把に書くと
順列と逆順列の混同
比較を単に文字列の比較でやってしまった
根本的な論理ミスはなくて良かったです。
77:08 AC 。 助かった。
苦手な理詰めゲーを(考察面は)ランダムテストなしで詰め切れたのは成長を感じます。
しかし……。通した時点でパフォーマンスは 2136 。時間をそこそこ残した AC にも関わらず思ったより高くないです。しかもペナルティ2個によってどんどん抜かされていきそうです。
────────
こういう嘘解法祭り問題は通常マルチテストケース で作られます。writer が想定していない嘘解法を物量作戦で確実に落とすためです。なのでこの問題がシングルテストケースなのは、テストケース作りへの自信が感じられて格好いいと思っていました。
ところが実際は嘘で通されまくっていたらしいです。格好いいどころか最もダサいパターンでした。
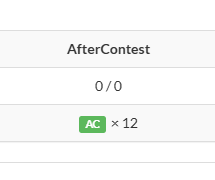
こういう場合コンテスト後に After Contest というテストケースが公式に追加されます。(が、コンテスト中の順位は不動)
山田のコードはこのケースも通過しました 。
もしテストケースが強ければどれくらいパフォーマンスが上がったかは分かりませんが、フレンズさんは山田の恨みを買ってしまいました。
G問題(間に合わず?)
問題文: G - Caeser Syllables
Difficulty: 2464
KCPCメンバー(rated参加) のAC率: 0/10
残り時間に絶対間に合わないので気楽に行きます。
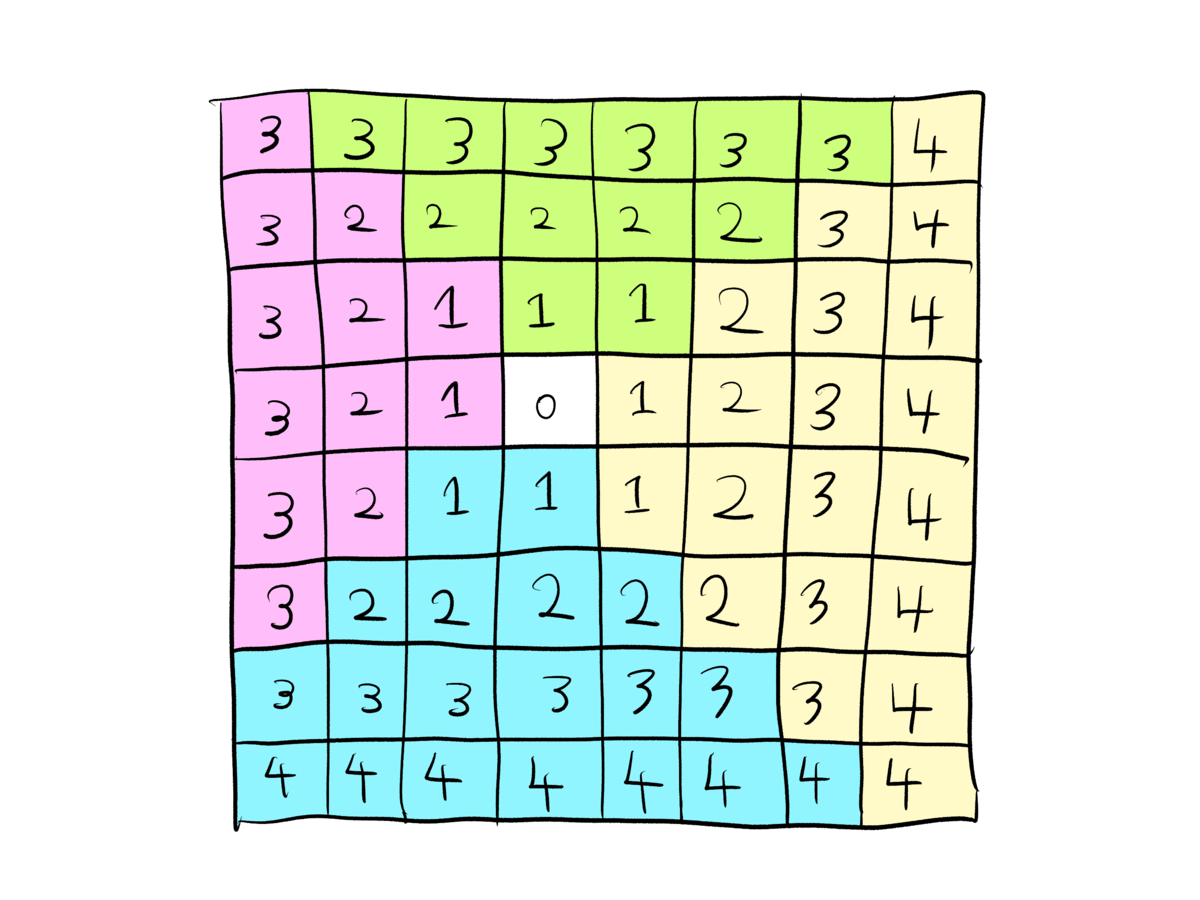
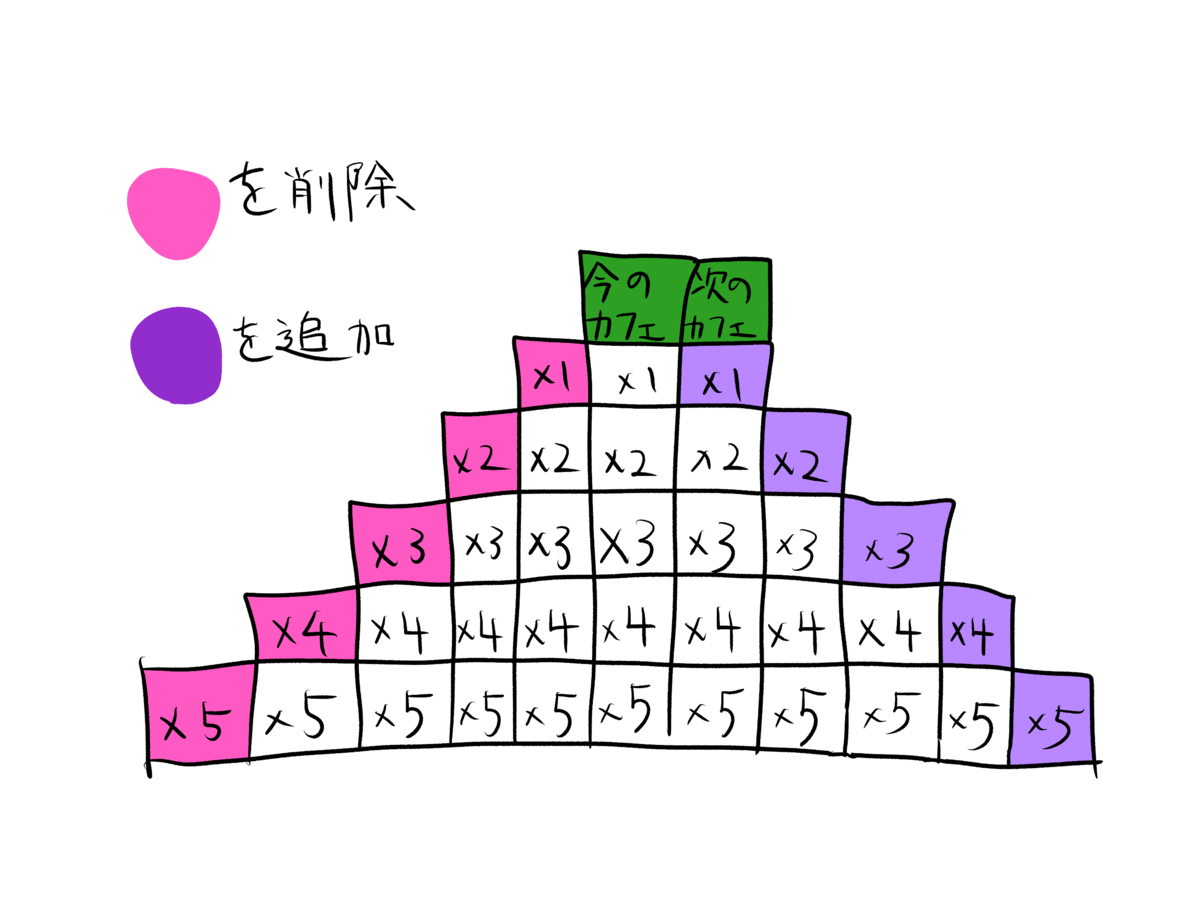
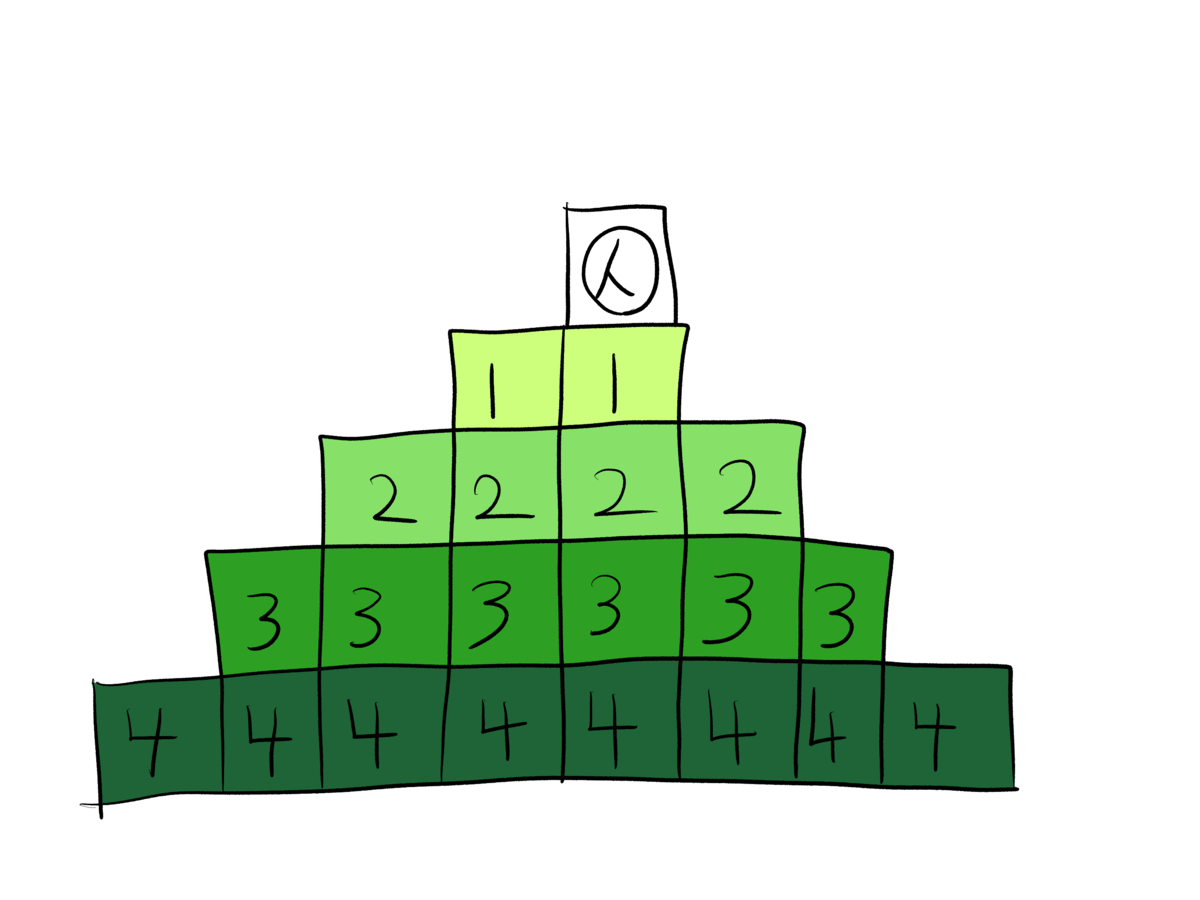
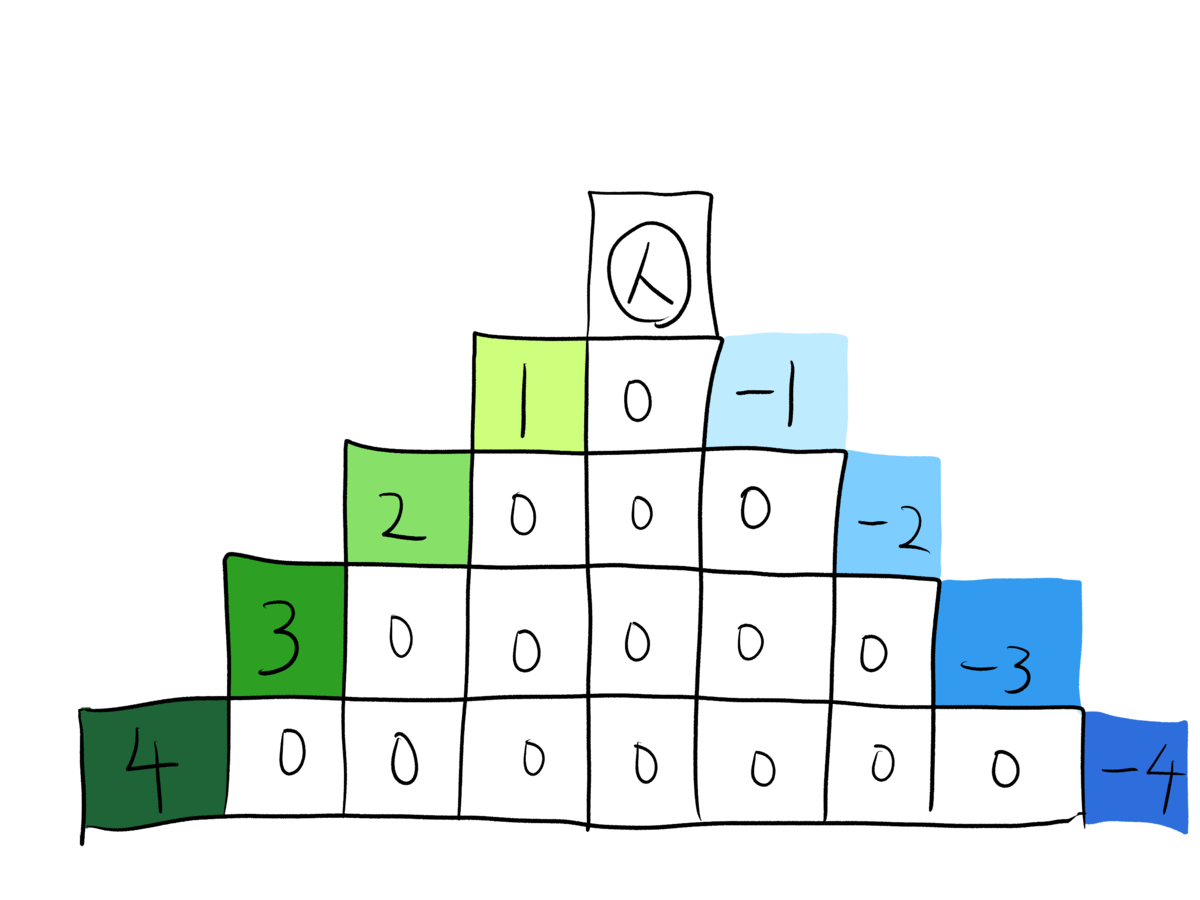
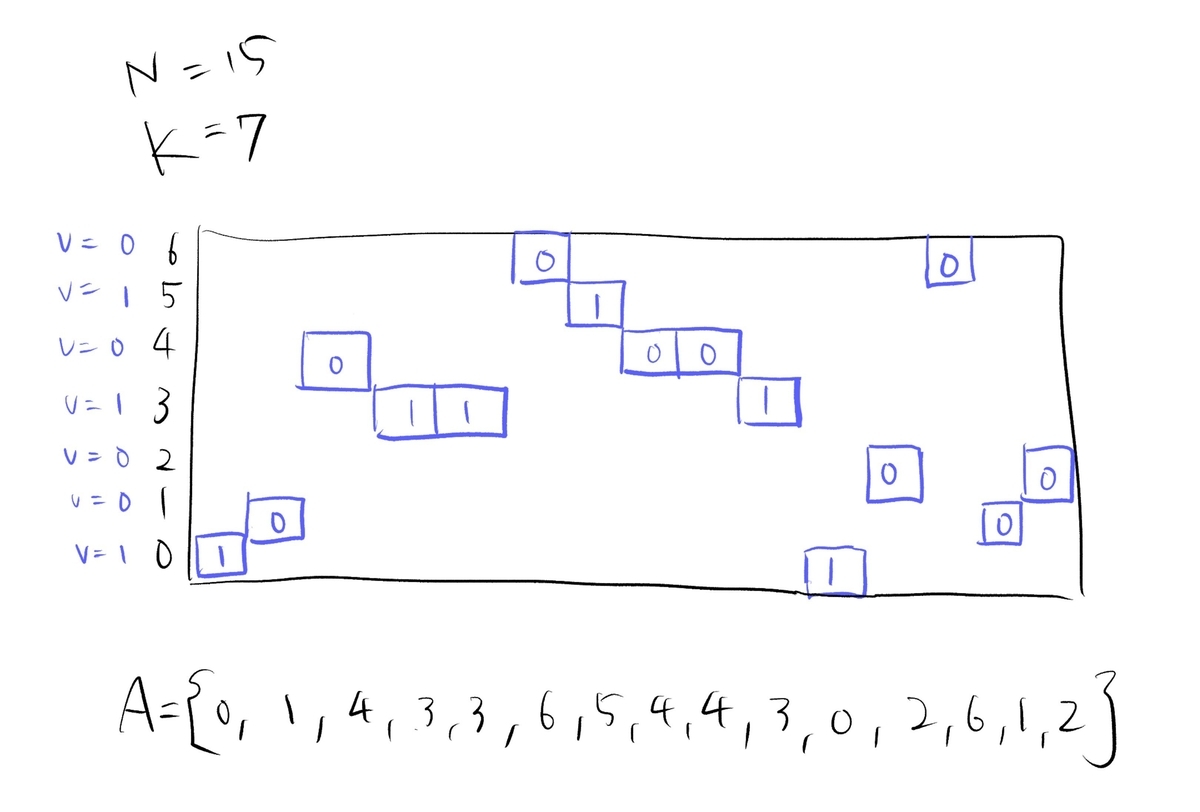
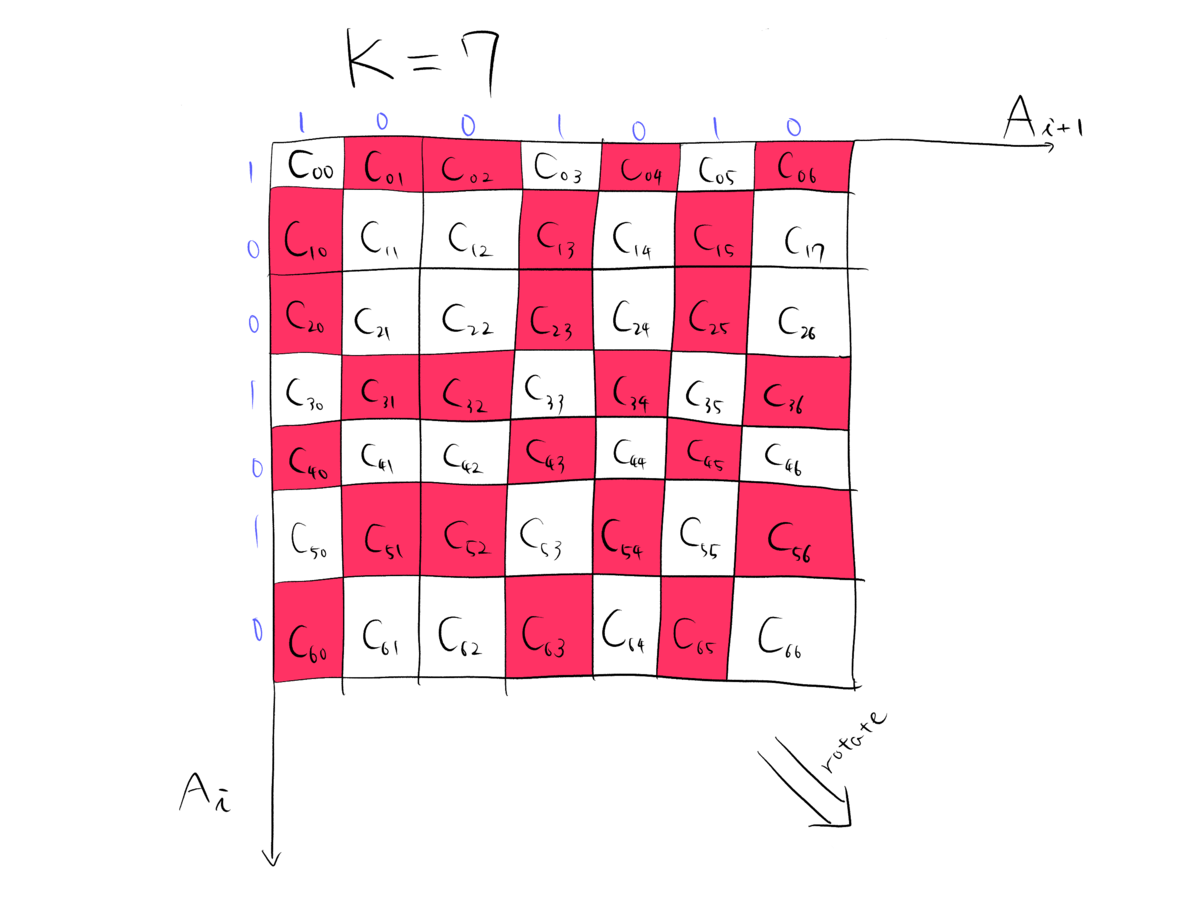
問題が複雑です。こういうのを人類の脳に優しくするには、適当に二次元グリッド を描いて捉えるのがいいと思います。
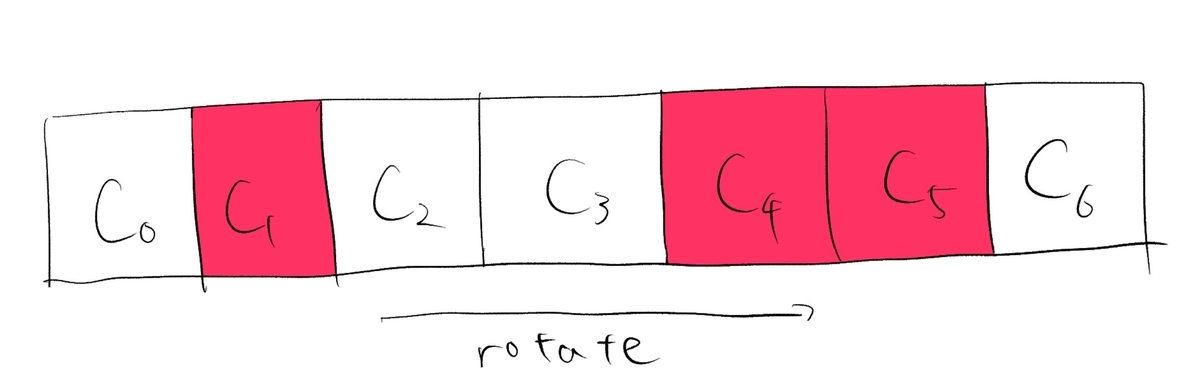
これの各ブロックを上に一つずつ rotate させていき、rotate 回数ごとに 階差 すれば計算できます。競プロ頻出の言い換えです。
そうなると重要なのは
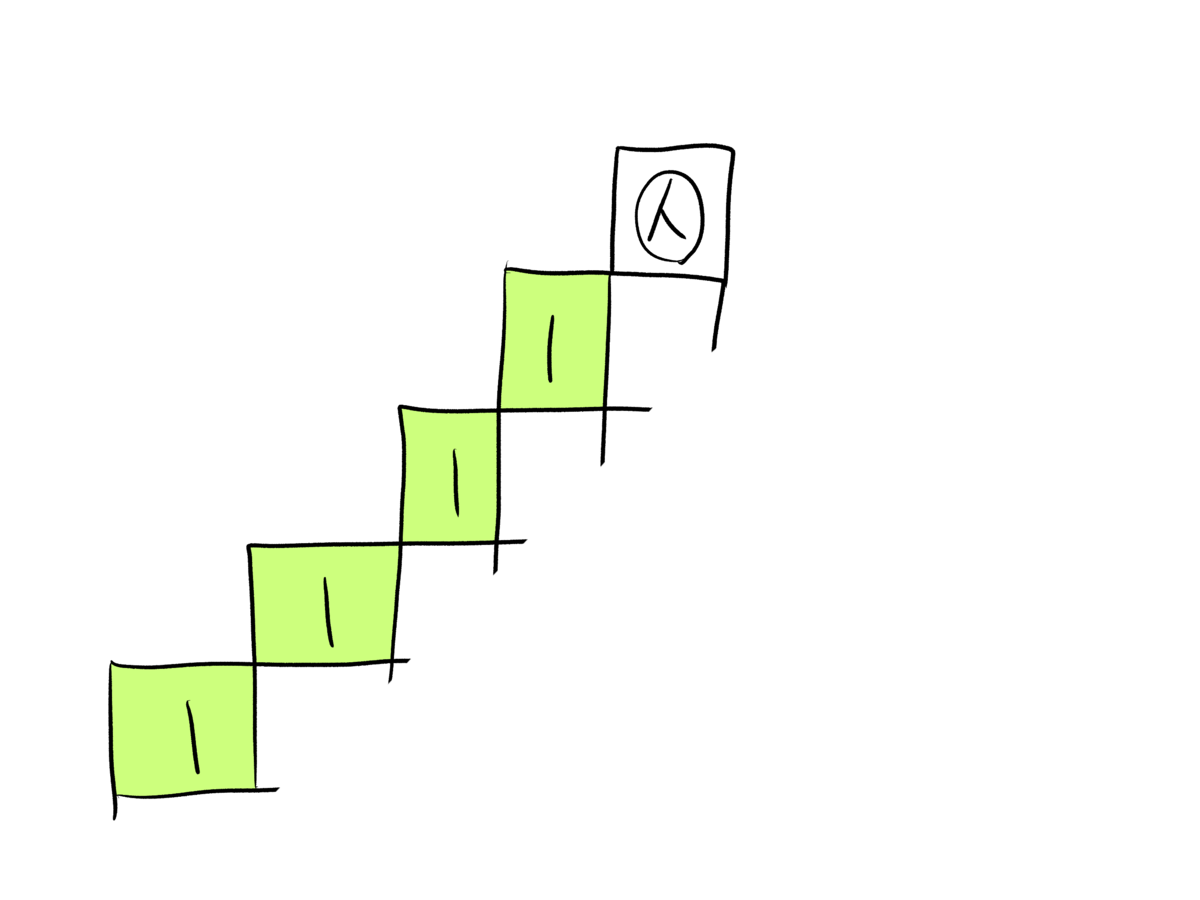
として、 以下の画像のようなイメージになりました。
この半市松模様(もしくは値)を右下に rotate していき、「赤マスに書かれた数の総和」を各 rotate
求まらないなと考えているうちにコンテスト終了。
────────
rotate 回数を先に固定することに拘りすぎていました。埒が明かなくなってきたので、視点を変えて斜めに分解 するということです。rotate されるのは右下方向なので、高低差ごとに独立に考える ことができます。
高低差
ここから rotate 回数ごとの赤マスの総和を 畳み込み です。解けたと思いました。
しかし不安なのは計算量です。ABC469E の時といい最近定数倍にビビりすぎな気がします)
コンテスト終了から 20 分経過。とりあえず実装してみます。
────────
入力部分の実装に 30 分かかりました……。
こんなに時間がかかった原因はオーバーフロー です。ありとあらゆる場所がオーバーフローしていました。本番中じゃなくて良かった。
実は C++ なら uint32_t、uint64_t がそれぞれ modint 2^32 と modint 2^64 になっている(除算以外)ので、楽に書けます。そしてその事実を山田は知っていましたが、不安なので __int128_t などを使って書きました。それが裏目に出ました。しかもオーバーフローを解決した後、流石に不格好すぎると思って結局 uint32_t と uint64_t を使った実装に書き換えました。
(何故このような特殊な入力形式になっているか、ここを読んでる層は知ってる方が多いと思いますが一応説明すると、入力は(特殊な高速化をしない限りは)定数倍が重いからです。数列の長さ
メインの実装も手間取りました。状況の複雑度が高く混乱します。畳み込みを使いそうなのは分かっていますが、どっちを reverse するかそれともしないかみたいな細かい判断でも混乱したので、頭を使うのをやめてサンプルに合わせに行く方向でガチャガチャと合わせました。
172:36 AC 。 実行時間は 660ms / 5000ms で余裕でした。想定も
72分36秒オーバーで全完。入力復元の実装で馬鹿なことしてなければ F との所要時間の差があまりないです。
コンテスト結果
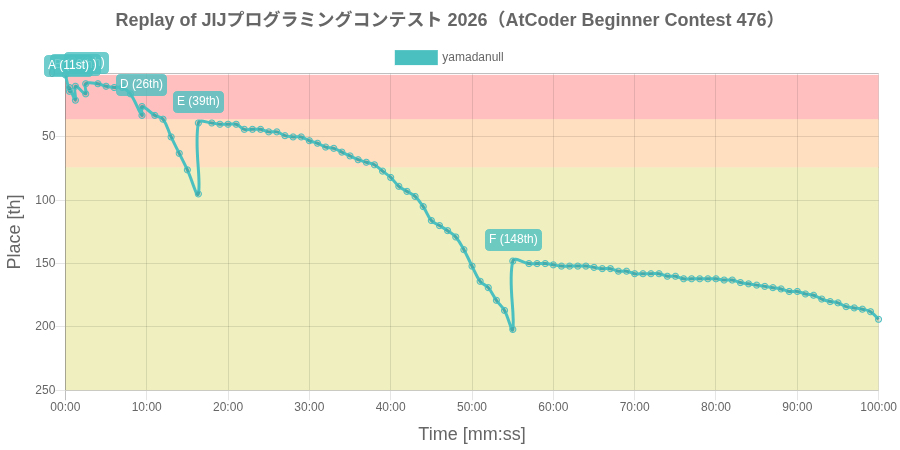
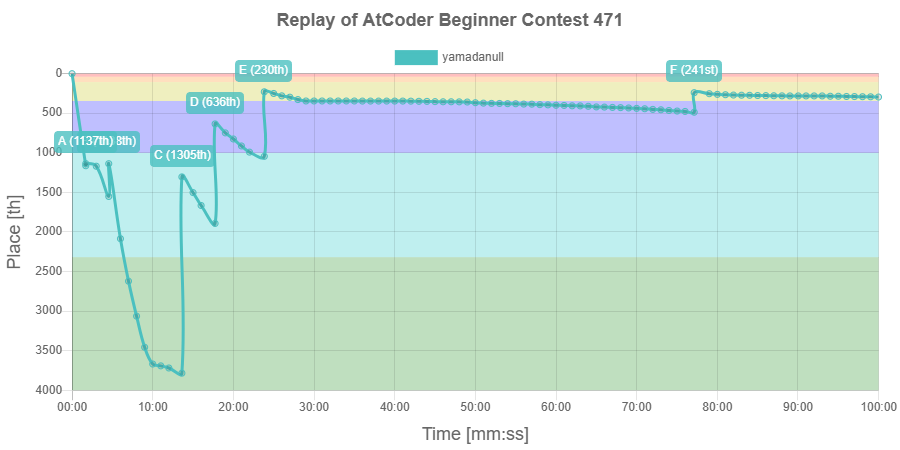
順位の推移
C 問題までで炎上しているものの最終的なパフォーマンスへの寄与は小さいです。
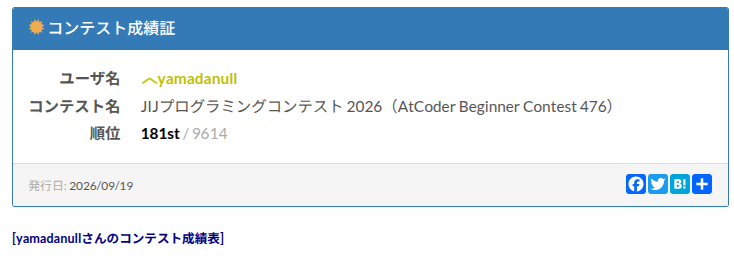
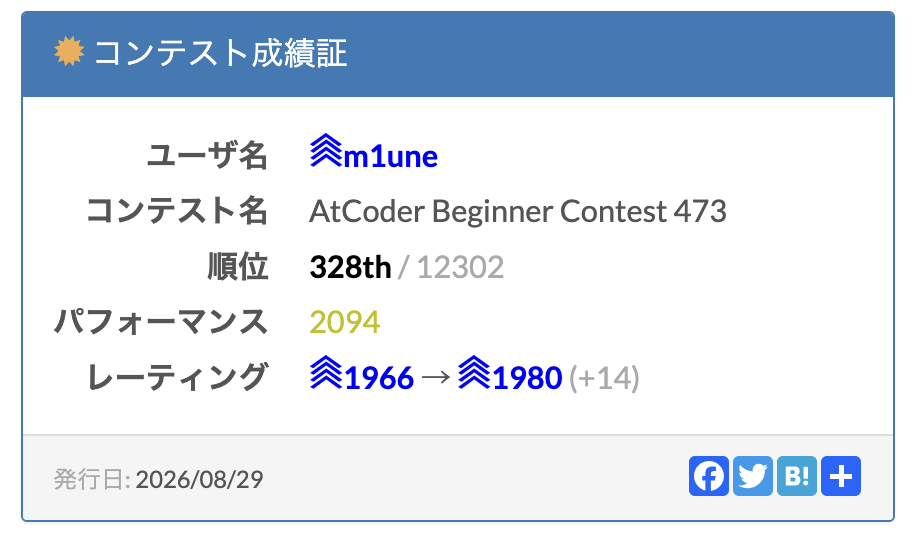
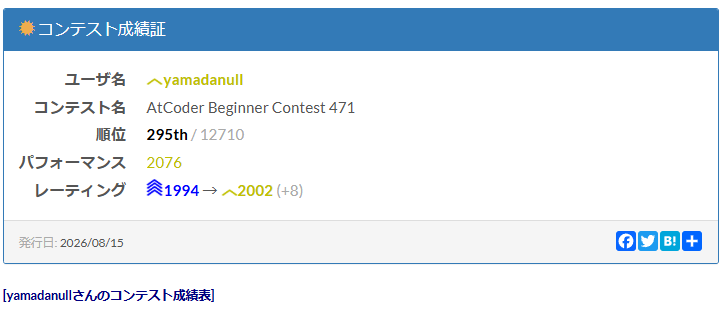
コンテスト成績証
ABCDEF の六完 (77:08 + ペナルティ 10 分)。黄色にギリギリ戻れました。(が、翌日の ARC227 でやらかして -46 の刑に処され、またしても黄色から大きく遠ざかりました。Help)
画面録画↓
https://youtu.be/jF258aFS0gI